Lecture de cache, écriture de cache, TTL de 5 minutes et d'1 heure : le calcul de tokens derrière chaque tour de Claude Code, et pourquoi un cache qui a expiré coûte plus cher que pas avoir de cache du tout.
AIagentsclaude-codecache
À chaque fois que vous appuyez sur Entrée dans Claude Code, le modèle relit toute votre conversation depuis la première ligne.
Ça a l’air cher, et ça le serait sans le prompt caching. C’est grâce au cache qu’une session de deux heures avec Claude Code reste abordable, et c’est aussi à cause de lui que le premier message après votre pause déjeuner peut coûter plus cher que les dix précédents.
Le prix et la consommation de tokens font partie des nouvelles choses que les développeurs qui utilisent des agents IA doivent apprendre. Et pour vraiment les comprendre, il faut d’abord comprendre comment fonctionne le système de cache. Dans cet article, on va donc le reprendre depuis le début : ce qui est mis en cache, ce que coûtent une lecture et une écriture de cache, comment fonctionnent les TTL de 5 minutes et d’1 heure, et ce qui casse le cache dans Claude Code.
Pas le temps ? Tout l’article existe aussi en vidéo de deux minutes, à la fin.
Ce qui arrive à votre message, des tokens au cache de prompt, sur trois requêtes
L’API de Claude est stateless. Les serveurs d’Anthropic ne gardent aucune mémoire de votre conversation entre deux messages. Donc à chaque fois que vous envoyez quelque chose, Claude Code renvoie tout : la définition des tools, le prompt système, votre CLAUDE.md, chaque message, chaque fichier lu, chaque sortie de commande.
Avant d’écrire le premier mot de sa réponse, le modèle doit traiter tous ces tokens. Cette étape s’appelle le prefill. Sur une session de 150k tokens, ça fait 150k tokens de travail à chaque tour, alors que 99 % d’entre eux sont exactement les mêmes qu’il y a une minute.
Requête 1
outils + système + CLAUDE.mdsystème
turn 1
30k
Requête 2
outils + système + CLAUDE.mdsystème
turn 1
turn 2
36k
Requête 3
outils + système + CLAUDE.mdsystème
turn 1
turn 2
turn 3
42k
Requête 4
outils + système + CLAUDE.mdsystème
turn 1
turn 2
turn 3
turn 4
48k
renvoyé et retraiténouveau dans cette requête
4 requêtes, 156k tokens traités pour 48k tokens de conversation
Chaque requête transporte tout l'historique, pas seulement le nouveau message
Vous vous demandez sûrement pourquoi personne ne garde simplement la conversation côté serveur. C’est justement ce que fait le prompt caching, mais à une seule condition.
Après avoir traité un prompt, le serveur peut garder le résultat de ce travail pendant un certain temps. Ce résultat, c’est l’état interne du modèle pour ces tokens (le KV cache), pas la réponse. À la requête suivante, si le début du prompt est identique à l’octet près, le serveur réutilise le travail stocké au lieu de le refaire.
La réponse, elle, n’est jamais mise en cache. Le modèle génère la même sortie avec ou sans cache. Le cache change seulement ce que vous payez pour l’entrée et la vitesse à laquelle arrive le premier token.
La règle dont tout découle, c’est que le cache fonctionne par correspondance de préfixe. Le serveur cherche le plus long début de votre prompt déjà stocké par une requête précédente. Changez un seul octet à la position N, et N plus tout ce qui suit est raté. Tout ce qui est avant N reste un succès.
C’est pour ça que l’ordre compte autant. La requête est toujours construite dans le même ordre : les tools, puis le prompt système, puis les messages. Un changement dans votre dernier message ne coûte rien de plus. Un changement dans la liste des tools ou dans le prompt système invalide toute la conversation qui se trouve derrière.
Vous croiserez aussi un dernier mot dans la documentation : les breakpoints (cache_control dans l’API). Le serveur n’enregistre pas le cache après chaque token. Il ne l’enregistre qu’à quelques positions que la requête marque, comme les points de sauvegarde d’un jeu vidéo. La requête suivante ne peut reprendre qu’à un endroit où une requête précédente a sauvegardé.
En pratique, Claude Code place un breakpoint à la fin de ce que chaque tour envoie. Quand vous envoyez votre message suivant, la requête commence exactement par le même contenu, le serveur retrouve ce point de sauvegarde, lit tout ce qui précède depuis le cache, et ne traite que ce qui vient après. Vous n’avez jamais à les placer vous-même.
Une requête peut porter au maximum 4 breakpoints. Et pour retrouver le point de sauvegarde
précédent, le serveur ne vérifie que les 20 dernières positions, une position étant un message, un
appel d’outil ou un résultat d’outil. Une série d’appels d’outils en parallèle compte pour une
seule position, tout comme la série de leurs résultats. Si un seul tour ajoute 20 positions ou
plus, par exemple une longue chaîne d’appels d’outils lancés l’un après l’autre, le point de
sauvegarde précédent est trop loin pour être retrouvé et toute la conversation est retraitée. À
part ça, un prompt plus court que le minimum du modèle (512 tokens sur les modèles les plus
récents, jusqu’à 4 096 sur certains plus anciens) n’est jamais mis en cache, sans aucune erreur.
La documentation du prompt
caching donne les détails.
Ne réutiliser que le début du prompt n’est pas un choix arbitraire de l’API, ça vient directement de la façon dont un modèle comme Claude lit du texte. Anthropic n’a pas publié le fonctionnement de ses propres serveurs, donc ce qui suit décrit ce que font les moteurs d’inférence open source comme vLLM, mais ça explique toutes les règles vues jusqu’ici.
Pour commencer, le modèle découpe votre prompt en tokens, des fragments qui font à peu près la taille d’un mot. Il les parcourt ensuite dans l’ordre et calcule pour chacun des vecteurs, de longues listes de nombres qui représentent ce qu’il veut dire à cet endroit du texte. Le sens d’un mot dépend de ce qui l’entoure. La « souris » de « le chat attrape la souris » n’a rien à voir avec celle de « je clique avec la souris ». Ses vecteurs dépendent donc des mots qui la précèdent. Le modèle refait ce calcul à chaque couche, ce sont les rangées L1 à L6 de la vidéo plus haut. Les vrais modèles en empilent des dizaines.
Pour le cache, deux de ces vecteurs comptent pour chaque token, la clé et la valeur, key et value en anglais, d’où le K et le V de KV cache. Chaque token suivant s’en sert pour « regarder en arrière » vers les tokens précédents et récupérer leur sens. Ce mécanisme s’appelle l’attention. L’ensemble des clés et valeurs d’un prompt forme le KV cache. Les calculer demande un passage complet du modèle sur chaque token, c’est le prefill lent et coûteux, et le prompt caching les garde après la requête au lieu de les jeter. Le cache ne stocke donc pas votre texte, et ce n’est pas non plus une base de données vectorielle. Il stocke les calculs intermédiaires du modèle sur votre texte.
Le point important, c’est qu’un token ne regarde qu’en arrière. Les clés et valeurs du token 500 dépendent des tokens 1 à 500, jamais de ce qui vient après. Donc si le token 200 change, les tokens 1 à 199 ne l’ont jamais vu, et leurs clés et valeurs restent parfaitement justes. Tous les tokens à partir du 200 ont été calculés avec l’ancien token 200, ils sont donc faux et doivent être recalculés. Le cache ne peut réutiliser que ce qui précède le premier changement. C’est la règle de correspondance de préfixe, et elle découle directement des maths.
Une vieille calculatrice imprimante, celle qui imprime chaque total cumulé sur un rouleau de papier, fonctionne de la même façon. Corrigez la saisie 5, et les totaux 1 à 4 restent justes, mais tous les totaux à partir de la ligne 5 doivent être réimprimés. Dans la figure ci-dessous, chaque ligne du rouleau est un token. Le code de 4 caractères à sa droite représente les clés et valeurs de ce token, et comme un total cumulé, il change dès que ce token ou un token au-dessus change. La machine imprime d’abord la requête 1. Le bouton « Changer le token 5 » envoie la requête 2, le même prompt avec un cinquième mot différent.
En couleur : les tokens recalculés dans la requête 2Grisés : les tokens réutilisés depuis le cacheLa requête 1 calcule les 8 tokens. La requête 2 change le token 5. Les tokens 1 à 4 viennent du cache. Les tokens 5 à 8 ont été calculés avec l’ancien mot, ils tombent donc dans le bac et sont recalculés.
Les mêmes mécanismes expliquent les autres règles du cache :
Règle
Pourquoi
Chaque modèle a son propre cache
Les clés et valeurs viennent des poids du modèle. Un autre modèle produit des vecteurs complètement différents, il n’y a donc rien à réutiliser
Les entrées expirent
Un KV cache est énorme. Sur Llama 3 70B, dont l’architecture est publique, c’est 80 couches x 8 têtes x 128 dimensions x 2 vecteurs x 2 octets, soit environ 320 Ko par token et 32 Go pour une conversation de 100k tokens. Cette mémoire est rare et partagée, donc les entrées sont évincées
Une écriture coûte plus cher qu’une entrée, et le TTL d’1 heure encore plus
Stocker des gigaoctets a un coût, et les garder 12 fois plus longtemps coûte plus cher. Ça, c’est mon interprétation, Anthropic ne publie pas son modèle de coûts
Une lecture n’est pas gratuite
Les clés et valeurs stockées doivent être rechargées, et vos nouveaux tokens regardent quand même tout l’historique
Les caches sont isolés par organisation
Le fait qu’un préfixe soit en cache se voit dans le temps de réponse. Des chercheurs de Stanford s’en sont servis pour détecter un partage de cache entre utilisateurs chez 7 fournisseurs d’API
Chaque réponse de l’API contient un bloc usage qui répartit l’entrée de la requête en trois catégories. Une fois que vous les connaissez, vous pouvez lire n’importe quelle facture Claude.
Champ
Ce qui s’est passé
Prix sur Claude Opus 5.5 (entrée de base à 4 $ le million de tokens)
cache_read_input_tokens
Trouvé dans le cache et réutilisé
0,05x, soit 0,20 $
cache_creation_input_tokens
Traité puis enregistré dans le cache
1,25x avec un TTL de 5 minutes (5 $), 2x avec un TTL d’1 heure (8 $)
input_tokens
Traité et pas enregistré
1x, soit 4 $
Le multiplicateur de lecture dépend du modèle : 0,1x sur la plupart, 0,05x sur Opus 5.5 et 0,025x sur Fable 5.1. Les tokens de sortie (20 $ le million sur Opus 5.5) ne sont jamais mis en cache.
Deux choses surprennent ici. D’abord, une écriture de cache coûte plus cher qu’une entrée normale. Vous payez un supplément pour stocker le travail, et il n’est rentable que si une requête suivante le relit. Ensuite, input_tokens n’est que le reste non mis en cache. La vraie taille du prompt, c’est la somme des trois champs, donc un tour qui affiche 300 input_tokens peut très bien avoir traité 100k tokens via le cache.
Une entrée de cache ne vit pas éternellement. Chacune a un TTL (time to live, sa durée de vie) : 5 minutes (par défaut, écritures à 1,25x) ou 1 heure (écritures à 2x). Trois détails comptent plus que le TTL lui-même :
Une lecture de cache remet le compteur à zéro gratuitement. Si vous envoyez un
message toutes les 3 minutes, même une entrée de 5 minutes reste chaude toute la journée.
Le compteur démarre au début de la requête, pas à la fin. Si Claude passe 4 minutes sur une longue réponse, une entrée de 5 minutes n’a plus qu’environ 1 minute devant elle quand il termine.
Quand l’entrée expire, le tour suivant est un raté complet. Toute la conversation est retraitée et réécrite, avec le supplément de coût à l’écriture.
Voici à quoi ressemble une pause déjeuner avec chaque TTL :
12:00
message
12:03
message
12:04 → 12:50
pause déjeuner
12:50
retour
TTL 5 min
ÉCRITURE
SUCCÈS
froid dès 12:08
RATÉ
TTL 1 h
ÉCRITURE
SUCCÈS
chaud jusqu'à 13:03
SUCCÈS
RATÉAvec 5 minutes, toute la conversation est retraitée et réécrite à 12:50
SUCCÈSAvec 1 heure, 12:50 est une lecture peu chère et l'entrée vit jusqu'à 13:50
La même pause déjeuner avec un TTL de 5 minutes et d'1 heure
Alors quel TTL utilise Claude Code ? Ça dépend de la façon dont vous payez, et il répartit les requêtes en deux groupes : la conversation principale (vos tours interactifs, claude -p, l’Agent SDK) et tout le reste (sous-agents, compaction, titres de session).
Conversation principale
Tout le reste
Abonnement (Pro, Max, Team, Enterprise)
1 heure
5 minutes
Clé API, Bedrock, Vertex, Foundry
5 minutes
5 minutes
Abonnement hors forfait (avec des usage credits)
5 minutes
5 minutes
Ce découpage a du sens quand on pense à qui attend. Un humain fait des pauses pour lire une diff, prendre un appel ou aller chercher un café, et le TTL d’1 heure couvre ces moments. Un sous-agent envoie en général sa requête suivante quelques secondes plus tard, donc 5 minutes suffisent et coûtent moins cher. La dernière ligne est celle à retenir : dès que vous passez hors forfait, vos pauses café se mettent à coûter des réécritures complètes.
Ces 5 minutes ne suffisent pas toujours aux sous-agents. Le compteur va du début d’une requête au début de la suivante, donc le temps d’exécution d’un outil compte aussi. Trois cas courants dépassent les 5 minutes sans que personne ne s’en rende compte :
un sous-agent qui lance une suite de tests de 7 minutes,
un sous-agent qui attend que vous validiez une demande de permission pendant que vous êtes loin de votre bureau,
un coéquipier d’une agent team. Les agent teams, ce sont plusieurs sessions Claude Code qui travaillent sur la même tâche et s’envoient des messages, donc un coéquipier attend souvent longtemps son prochain message.
Dans les trois cas, l’entrée expire pendant l’attente, et la requête suivante retraite et réécrit tout l’historique.
Vous pouvez changer le TTL des deux groupes (Claude Code v2.1.242 et plus) avec les réglages promptCacheTtl et subagentPromptCacheTtl, ou les variables d’environnement CLAUDE_CODE_PROMPT_CACHE_TTL et CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL. Chacun accepte 5m ou 1h. Pour les sous-agents par contre, je ne les passerais pas tous à 1 heure : chaque petit sous-agent d’exploration paierait l’écriture à 2x pour rien. Mettez plutôt cacheTtl: 1h dans le frontmatter experimental des quelques agents qui attendent (v2.1.248 et plus) et gardez 5 minutes pour les autres.
Mettons des chiffres dessus. Vous êtes sur Opus 5.5, votre session fait 100k tokens, et le tour suivant ajoute 2k nouveaux tokens (votre message, la dernière réponse et un peu de sortie d’outil).
Situation
Calcul
Coût d’entrée du tour
Cache chaud, TTL d’1 heure
100k lus à 0,20 $ + 2k écrits à 8 $
environ 0,036 $
Aucun cache
102k à 4 $
environ 0,41 $
Cache froid, TTL de 5 minutes
102k écrits à 5 $
environ 0,51 $
Cache froid, TTL d’1 heure
102k écrits à 8 $
environ 0,82 $
Un tour avec le cache chaud coûte environ 11 fois moins cher que sans cache, et c’est ce qui rend les longues sessions abordables. Mais regardez les deux dernières lignes : un cache froid coûte plus cher que pas de cache du tout, parce que vous payez le supplément d’écriture sur toute la conversation. Plus la session est grosse, plus la facture est lourde quand elle refroidit. C’est la pause café du titre.
Alors combien de requêtes faut-il pour qu’une écriture soit rentable ? Voici le coût d’entrée quand on envoie plusieurs fois le même préfixe, compté en prix plein de ce préfixe (1x pour le traiter, 1,25x ou 2x pour l’écrire, 0,05x pour le lire sur Opus 5.5) :
Requêtes sur le même préfixe
Sans cache
TTL de 5 minutes
TTL d’1 heure
1
1
1,25
2
2
2
1,30
2,05
3
3
1,35
2,10
En vert, c’est moins cher que sans cache, en rouge plus cher. Une écriture à 5 minutes est rentable dès la deuxième requête, une écriture à 1 heure dès la troisième. Avec la lecture à 0,1x de la plupart des autres modèles, les seuils restent les mêmes.
Avec un abonnement, vous ne voyez pas de dollars, mais la logique est la même : un long contexte consomme toujours votre quota, même au tarif du cache, donc un cache froid sur une grosse session entame vos limites plus vite.
C’est l’objection légitime. Avec le TTL d’1 heure, chaque nouveau token écrit coûte 2x au lieu de 1,25x, à chaque tour. Si vous enchaînez les messages et envoyez le suivant dans les quelques minutes, une entrée de 5 minutes serait restée chaude de toute façon, et vous avez payé les 0,75x de plus pour rien.
Pour un trafic continu, c’est vrai. Une boucle d’agent ou un script qui appelle l’API toutes les quelques secondes ne laisse jamais une entrée de 5 minutes expirer, donc le TTL de 5 minutes est strictement moins cher dans ce cas. Ça correspond à ce que fait Claude Code par défaut : 5 minutes pour les sous-agents et pour les utilisateurs avec une clé API.
Pour un humain, le calcul s’inverse. Dans la session de 100k tokens ci-dessus, le supplément du TTL d’1 heure sur une écriture de 2k tokens vaut 2k x (8 $ - 5 $) par million, soit environ 0,006 $ par tour. Un seul cache froid avec le TTL de 5 minutes coûte environ 0,51 $ au lieu de 0,036 $. Il faudrait autour de 80 tours de supplément pour payer un seul raté évité, et la plupart des gens font plus d’une pause en 80 tours.
Maintenant que vous savez que le cache est une correspondance de préfixe, la plupart de cette liste va vous paraître logique. Tout ce qui change le début du prompt le casse, tout ce qui ajoute seulement à la fin le garde.
Action
Cache
Pourquoi
Changer de modèle avec /model
casse
Chaque modèle a son propre cache. Ça inclut le changement de opusplan en mode plan et les skills qui utilisent un autre modèle
Changer l’effort
casse
Sur la plupart des modèles, le niveau d’effort fait partie du prompt, avant la conversation. Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1 gardent le cache avec une clé API ou un abonnement, parce que Claude Code envoie le nouveau niveau dans un message à la fin de la conversation. Pas sur Bedrock, Google Cloud ou la passerelle Claude apps
Ajouter ou retirer des outils MCP
casse
Seulement quand les outils sont chargés d’emblée. Avec le tool search (par défaut), la liste d’outils de la première requête est conservée
/compact
casse
La conversation est reconstruite. La couche du prompt système est réutilisée
Mettre à jour Claude Code
casse
Le prompt système change avec la version
Rester inactif plus longtemps que le TTL
casse
L’entrée a expiré
Permission mode, output style, commandes slash, plan mode, /rewind
garde
Rien ne change avant votre nouveau message. Sauf le plan mode avec opusplan, qui change de modèle
Ajouter ou invoquer un skill en cours de session
garde
Sa description ou son contenu est ajouté après la conversation. Un skill invocable par le modèle coûte quand même quelques tokens à chaque tour, donc disable-model-invocation: true garde hors du contexte un skill que vous lancez seulement à la main
Lancer un sous-agent
garde
Le sous-agent construit son propre cache et laisse le vôtre tranquille. Un fork réutilise votre préfixe et lit votre cache
Activer ou désactiver /advisor
garde
Sa définition d’outil se trouve après le breakpoint du cache
Modifier CLAUDE.md en cours de session
garde
Parce que la modification n’est pas encore appliquée
Cette dernière ligne mérite sa propre explication, parce qu’elle n’est pas intuitive.
/compact mérite aussi qu’on s’y attarde. Tant que le cache est chaud, il ne coûte pas grand-chose, parce que le résumé est construit à partir de tokens en cache. Après une longue pause, c’est le chemin le plus cher : il doit relire toute la conversation froide juste pour la résumer. Si vous revenez au bout d’une heure et que vous n’avez plus besoin de l’ancien contexte, /clear coûte bien moins cher que de continuer ou de compacter.
À l’inverse, compacter tôt, à une pause naturelle entre deux tâches, est une bonne habitude. Chaque tour relit tout l’historique. À 0,05x c’est peu cher par tour, mais sur une session de 200k tokens ça fait quand même environ 0,04 $ par tour sur Opus 5.5, et tout ce qui tourne mal (un cache froid, un changement de modèle) coûte en proportion de cette taille. Compacter pendant que le cache est chaud garde tout ça petit. Évitez juste de le faire en plein milieu d’une tâche : le résumé perd des détails, et Claude risque de devoir relire les fichiers qu’il vient d’oublier.
L’advisor permet à Claude de consulter un second modèle, en général plus puissant, à des moments clés. Je ne le recommande pas, et le cache en est la raison principale.
Activer /advisor garde votre cache, mais l’advisor lui-même n’en a jamais. À chaque fois que Claude le consulte, le modèle advisor reçoit toute la transcription, chaque appel d’outil et chaque résultat compris, et la traite sans cache, sans aucune réutilisation d’un appel à l’autre. Même quand l’advisor est le même modèle que votre modèle principal, il ne lit pas votre cache.
Et ce n’est pas vous qui choisissez quand ça arrive. C’est Claude qui décide, et il a tendance à appeler l’advisor avant de déclarer une tâche terminée, donc à la fin d’une longue session, quand la transcription est la plus grosse. C’est comme ça qu’un seul appel à l’advisor m’a coûté 700k tokens d’un coup : un appel à la fin d’une grosse session, avec tout le contexte envoyé au prix fort. Aux prix d’Opus 5.5, ça fait 2,80 $ d’entrée pour un seul appel, là où relire ces mêmes 700k depuis un cache chaud coûte 0,14 $.
En plus de ça, je n’ai vu aucune amélioration de qualité pendant que je l’avais activé. Donc je l’ai coupé avec /advisor off. Si vous voulez vous en débarrasser pour de bon, CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1 le désactive complètement.
Pas besoin de me croire sur parole. Claude Code vous montre tout ça.
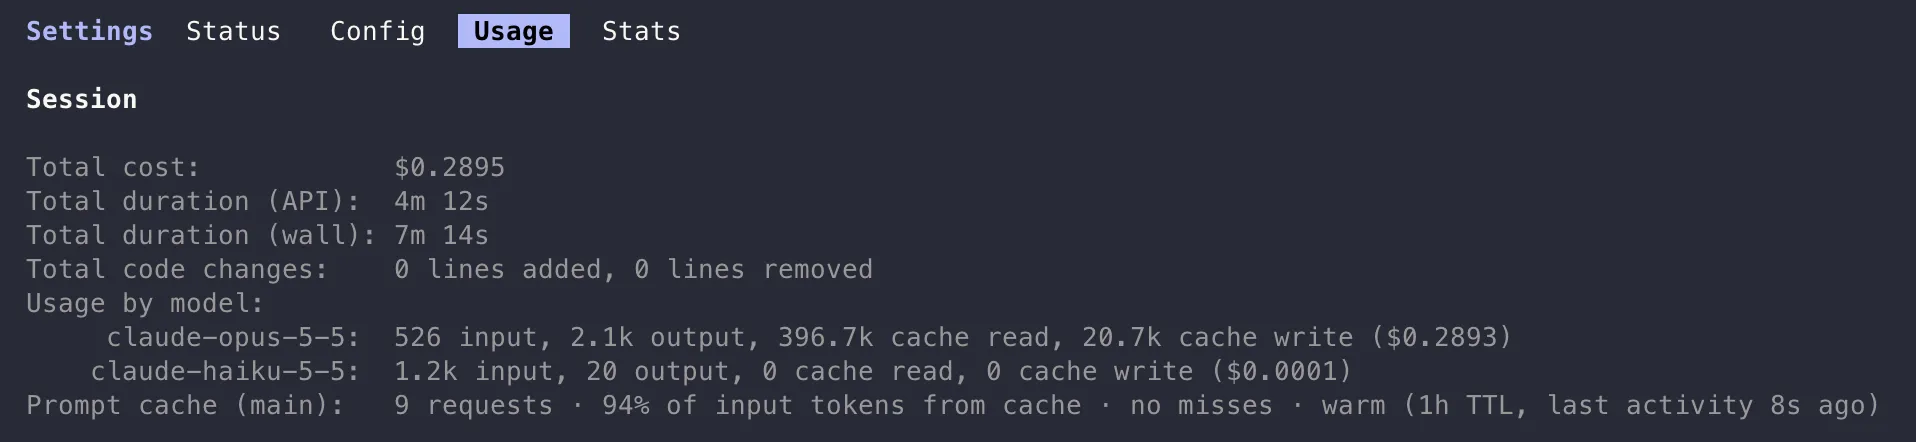
/usage affiche une ligne Prompt cache (main) dans son bloc Session (v2.1.251 et plus) avec le taux de succès, les ratés, l’état chaud ou froid du cache et le TTL utilisé. Voici à quoi ça ressemble dans le terminal à la fin d’une courte session :
/usage dans le terminal : la ligne Prompt cache (main) résume le cache de la session
La ligne Prompt cache (main) dit tout : 9 requêtes, 94 % des tokens d’entrée lus depuis le cache, aucun raté, et le cache est encore chaud avec le TTL d’1 heure d’un abonnement. La ligne Opus permet aussi de vérifier les calculs de cet article : 396,7k tokens lus à 0,20 $ le million, 20,7k écrits à 8 $ (TTL d’1 heure), 526 hors cache à 4 $ et 2,1k de sortie à 20 $ donnent bien les 0,2893 $ affichés. Sans le cache, ces mêmes 418k tokens d’entrée auraient coûté environ 1,67 $ au lieu de 0,25 $.
Encore mieux, votre status line peut l’afficher en permanence, pour savoir si le cache est froid avant d’envoyer un message. Vous n’avez même pas besoin d’écrire le script : tapez /statusline suivi de ce que vous voulez, et Claude Code le génère pour vous.
plaintext
/statusline affiche l'état du prompt cache : chaud ou froid, le TTL et les minutes restantes avant expiration
Le script lit l’objet prompt_cache que Claude Code transmet à votre status line (v2.1.251 et plus) : warm, ttl, expires_at, hit_ratio, et le plus utile ici, recache_tokens_if_cold, le nombre de tokens que votre prochaine requête réécrira si le cache a refroidi. La status line se rafraîchit aussi toute seule quand le cache atteint expires_at, donc elle passe à froid sans que vous ayez rien à faire.
Pour voir quel TTL vous obtenez, lancez une requête ponctuelle et regardez le bloc usage :
bash
claude -p "hello" --output-format json
usage.cache_creation.ephemeral_1h_input_tokens comparé à ephemeral_5m_input_tokens vous dit quel TTL a été écrit.
Ce que vous voulez voir dans une session en bonne santé : cache_read grossit à chaque tour, parce qu’il couvre tout ce qui précède, et cache_creation reste petit, parce que ce n’est que ce que le dernier tour a ajouté. Si cache_creation est proche de la taille de toute la conversation à chaque tour, quelque chose change le début du prompt en permanence.
Si vous exportez les métriques de Claude Code, la métrique claude_code.token.usage a un attribut
type avec les valeurs input, output, cacheRead et cacheCreation, et l’événement
claude_code.api_request porte cache_read_tokens et cache_creation_tokens. Voir la
documentation sur le monitoring.
Le prompt caching se résume à une règle : le serveur réutilise le plus long début inchangé de votre prompt, tant que l’entrée est en vie. Les lectures sont presque gratuites, les écritures coûtent plus cher qu’une entrée normale, et un cache froid sur une grosse session coûte plus cher que pas de cache du tout.
En pratique, ça donne quelques habitudes :
Choisissez votre modèle au début de la session, et utilisez des sous-agents pour les modèles moins chers au lieu de changer avec /model.
Après une longue pause, demandez-vous si vous avez encore besoin de l’ancien contexte. Sinon, /clear plutôt que de continuer ou de compacter.
Gardez les grosses sorties de commandes hors de la conversation. Elles sont relues à chaque tour, peu cher par tour mais ça s’accumule, et elles remplissent votre fenêtre de contexte.
Attention au hors forfait. Dès que vous utilisez des usage credits, la conversation principale repasse au TTL de 5 minutes. Mettez promptCacheTtl à 1h si vous faites de longues pauses.
Compactez tôt, entre deux tâches et pendant que le cache est chaud, pour garder un contexte petit.
Laissez /advisor désactivé. Chaque appel relit toute la conversation sans aucun cache, et vous ne contrôlez pas quand il arrive.
Mettez l’état du cache dans votre status line, pour savoir quand votre prochain message tombera sur un cache froid.
Voici tout l’article en deux minutes, pour le revoir ou le partager. Chaque bouton de chapitre vous emmène directement à la partie correspondante.